
Na tej stronie
Rozważ ilustracyjne zadanie w przeglądarce złożone ze stu kroków. Załóżmy, że każdy z nich udaje się w 99% przypadków, niezależnie od pozostałych. Szansa, że wszystkie się powiodą, wynosi 0.99^100, czyli około 36,6%.
Dziewięćdziesiąt dziewięć procent brzmi znakomicie. Trzydzieści sześć procent już nie.
Omówienie zadań transakcyjnych w przeglądarce używa tego rachunku do wąskiego wniosku: klient otrzymuje wartość dopiero po ukończeniu zadania, a koszt i ryzyko błędu rosną z każdym krokiem. To arytmetyka oparta na założeniu, nie opublikowana skuteczność jakiegokolwiek agenta przeglądarkowego ani synchronizacji Tajo. Rzeczywiste błędy mogą od siebie zależeć. Jedna wygasła sesja może zepsuć kilka późniejszych działań.
Właściwe pytanie nie brzmi więc „Jak trafne było ostatnie kliknięcie modelu?”, tylko „Czy pojawił się stan, o który prosił użytkownik?”.
Liczy się całe zadanie
Wyobraź sobie agenta, który otwiera portal ubezpieczeniowy, znajduje dokument, pobiera go i potwierdza, że należy do właściwego konta. Może poprawnie przejść 99 ekranów, a na setnym pobrać niewłaściwy plik. Dziennik pełen udanych kliknięć nie naprawi wyniku.
Ta sama różnica dotyczy integracji. Agent może odkryć API, zaproponować mapowanie pól i zapisać szkic. Żadne z tych działań nie oznacza, że kontakt w systemie docelowym ma właściwy stan zgody. Praca kończy się dopiero po wykonaniu zatwierdzonej operacji i sprawdzeniu odpowiedniego stanu końcowego.
To różnica między aktywnością a ukończeniem. Aktywność łatwo policzyć. Ukończenie trzeba zdefiniować.
Przy pobieraniu pliku kryterium może być dokument z identyfikatorem konta zgodnym z żądaniem. Przy synchronizacji kontaktu może to być rekord docelowy z właściwym identyfikatorem, polami i statusem zezwolenia na wiadomości. Kontrola musi dotyczyć tego, na czym zależało użytkownikowi. Pozytywna odpowiedź poprzedniego wywołania dowodzi, że wywołanie wróciło. Niekoniecznie dowodzi, że system docelowy zmienił się zgodnie z planem.
Przewodnik Tajo po łączeniu narzędzi biznesowych zaczyna od procesu i źródła prawdy dla każdego obiektu danych. Te wybory nadają sens końcowej kontroli. Jeśli dwa systemy roszczą sobie prawo do tego samego pola, nawet poprawnie wykonany zapis może dać zły stan długoterminowy.
Cena kolejnej decyzji
Przy tym samym hipotetycznym założeniu 99% dziesięć niezależnych decyzji daje około 90,4% szans na sukces całego łańcucha. Pięćdziesiąt daje około 60,5%. Sto daje około 36,6%.
Prawdopodobieństwo powodzenia całego łańcucha (%)
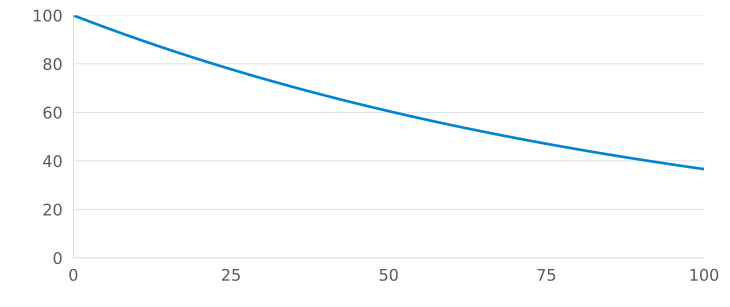
Liczba niezależnych kroków
- Zakładana skuteczność 99% na krok
Zobacz obliczone wartości
| Kroki | Sukces całego łańcucha (%) |
|---|---|
| 0 | 100,0 |
| 10 | 90,4 |
| 25 | 77,8 |
| 50 | 60,5 |
| 75 | 47,1 |
| 100 | 36,6 |
Krzywa szybko opada, ponieważ mnożenie nie zważa na dobrą średnią. Każda kolejna decyzja musi uzasadnić swoje miejsce.
Nie znaczy to, że wszystkie wywołania API należy zwinąć w jedną ogromną operację. Niektóre są deterministyczne: pobranie strony ze znanym kursorem, porównanie identyfikatora lub zapis pola według zatwierdzonego mapowania. Model nie musi ponownie decydować o nich dla każdego rekordu. Inne wywołania wiążą się z rzeczywistą niejednoznacznością: nowe pole dostawcy, zmieniony komunikat błędu albo żądanie bez jasnego właściciela. Mogą wymagać osądu.
Praktyczny podział jest taki: osąd projektuje lub poprawia regułę, a zwykły kod stosuje stabilną regułę. Reverse ETL jest przykładem powtarzalnego przenoszenia danych: każdy rutynowy wiersz powinien przetwarzać pipeline, a nie rozmowa. Agent nadal może pomóc ustalić, co pipeline powinien robić.
To granica odpowiedzialności, nie hasło. Jeśli dostawca zmieni znaczenie pola, deterministyczna reguła może bezbłędnie powtarzać niewłaściwe działanie. System musi wykrywać zmianę założeń i kierować przypadek do ponownej oceny.
Dlaczego jedno wielkie narzędzie nie wystarczy
Uczciwy zarzut brzmi: „Skoro długie łańcuchy zawodzą, umieśćmy całe zadanie za jednym wywołaniem narzędzia”. To pomaga, gdy narzędzie jest dobrze zdefiniowaną transakcją ze sprawdzalnym wynikiem. Zawodzi, gdy tylko ukrywa długi, niepewny proces.
Załóżmy, że syncCustomer() zwraca success: true po wysłaniu aktualizacji. Jeśli system docelowy przetwarza aktualizacje później, wywołanie nie może jeszcze dowieść końcowego stanu kontaktu. Narzędzie zmniejszyło liczbę widocznych kroków. Nie zmniejszyło niepewności.
Lepszy interfejs pokazuje stan, który ma znaczenie: przyjęto, zastosowano, sprawdzono albo odrzucono. Te słowa powinny odpowiadać dowodom. Przyjęty zapis może wystarczyć przy podglądzie bez istotnych konsekwencji. Zmiana odbiorców kampanii lub zgody wymaga kontroli w systemie docelowym, zanim ktoś uzna ją za ukończoną.
W tym proponowanym widoku Tajo przyjęte żądanie i zastosowana aktualizacja nie są tym samym co zweryfikowany stan docelowy. Końcowa kontrola wciąż oczekuje. To rozróżnienie nadaje cel następnemu działaniu: sprawdzeniu, co zapisał system docelowy. Kolejne udane wywołanie narzędzia nie odpowiedziałoby na pierwotne pytanie.
Zakończony zapis nadal wymaga dowodów
Czy synchronizacja klienta dobiegła końca?
Zapis zastosowany. Weryfikacja oczekuje.
Stan w systemie docelowym nie został jeszcze sprawdzony.
Aktywność synchronizacji
- Żądanie przyjęte
- Aktualizacja zastosowana
- Kontrola systemu docelowego oczekuje
Przykładowe wykonanie · 14:32 UTC
Co wiemy
- Odpowiedź dostawcy
- Przyjęte
- Wynik zapisu
- Zastosowana
- Ponowny odczyt z systemu docelowego
- Oczekuje
Udane wywołanie nie dowodzi stanu końcowego.
Proponowany układ oparty na rejestrze aktywności Tajo. Ilustracja dodaje stan weryfikacji, ale nie twierdzi, że ponowny odczyt z systemu docelowego jest już wdrożony.
To zmienia także pomiar. Notuj liczbę prób, jeśli pomaga rozpoznać koszt. Notuj błędy pośrednie, jeśli wskazują uszkodzony krok. Oceniaj jednak proces po zweryfikowanych, ukończonych zadaniach, podając sposób weryfikacji obok liczby. Zespół raportujący „99% wywołań zakończyło się sukcesem” nie odpowiedział, czy klienci wykonali swoją pracę.
Wyjaśnienie serwerów MCP pokazuje, jak narzędzia pozwalają asystentowi wywołać inny system. Dostęp do narzędzia to dopiero początek. Umowa dotyczy stanu, który po nim pozostaje.
Sto dobrych kliknięć może nie dać niczego. Licz wynik.
Najczęściej Zadawane Pytania
Dlaczego długi proces zawodzi, skoro poszczególne kroki zwykle się udają?
Jeśli każdy krok udaje się niezależnie z prawdopodobieństwem p, cały łańcuch n kroków udaje się z prawdopodobieństwem p do potęgi n. Przy założeniu 99% na krok sto kroków kończy się sukcesem w około 36,6% przypadków. Rzeczywiste błędy mogą być zależne, więc to ilustracja, a nie zmierzona skuteczność agentów.
Czy ograniczenie liczby wywołań narzędzi gwarantuje niezawodność?
Nie. Mniej wywołań pomaga tylko wtedy, gdy połączona operacja nadal ujawnia potrzebne kontrole i punkty odzyskiwania. Jedno nieprzejrzyste wywołanie może ukryć nieudaną zmianę równie łatwo, jak długi łańcuch może zgubić kontekst.
Co zespół powinien mierzyć w procesie z agentem?
Mierz zweryfikowane wykonanie zadania użytkownika, a nie tylko udane wywołania modelu. Określ artefakt lub stan w systemie docelowym, który dowodzi ukończenia pracy, i notuj, jak często pojawia się po całym procesie.