
На этой странице
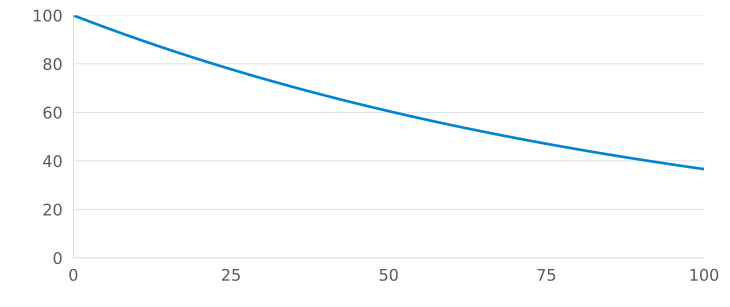
Возьмём условную задачу в браузере из ста шагов. Пусть каждый шаг успешен в 99% случаев независимо от остальных. Вероятность, что сработают все шаги, равна 0.99^100, то есть около 36,6%.
Девяносто девять процентов звучит отлично. Тридцать шесть процентов уже нет.
Обсуждение транзакционных задач в браузере использует этот расчёт для узкого вывода: клиент получает пользу, когда задача выполнена, а затраты и риск сбоя накапливаются на каждом шаге. Это арифметика при допущении, не опубликованная статистика браузерного агента или синхронизации Tajo. Реальные ошибки могут зависеть друг от друга. Истёкшая сессия способна сломать сразу несколько следующих действий.
Поэтому полезный вопрос звучит не «Насколько точным был последний клик модели?», а «Возникло ли состояние, которое запросил пользователь?»
Значима вся операция
Представьте агента, который открывает страховой портал, находит документ, скачивает его и проверяет принадлежность нужному аккаунту. Он может правильно пройти 99 экранов и скачать чужой файл на сотом. Журнал успешных кликов результата не исправит.
В интеграции различие то же. Агент находит API, предлагает сопоставление полей и сохраняет черновик. Ни одно из этих действий не означает, что контакт в системе назначения получил нужный статус согласия. Работа закончена только после выполнения одобренной операции и проверки её значимого конечного состояния.
Это различие между активностью и завершением. Активность считать легко. Для завершения нужно определение.
При скачивании файла таким определением может быть документ с номером аккаунта из запроса. При синхронизации контакта это запись назначения с правильным идентификатором, полями и допустимым статусом сообщений. Проверка должна смотреть на то, ради чего пользователь начал работу. Положительный ответ предыдущего вызова доказывает, что вызов вернул ответ. Он не всегда доказывает, что назначение изменилось как нужно.
Руководство Tajo по подключению бизнес-инструментов начинается с рабочего процесса и источника истины для каждого объекта. Эти решения задают смысл конечной проверки. Если две системы считают себя владельцами одного поля, даже безупречная запись способна создать неверное долгосрочное состояние.
Цена ещё одного решения
При тех же условных 99% десять независимых решений дают около 90,4% успеха всей цепочки. Пятьдесят дают около 60,5%, сто дают около 36,6%.
Вероятность успеха всей цепочки (%)
Количество независимых шагов
- Предполагаемый успех шага: 99%
Посмотреть расчётные значения
| Шаги | Успех всей цепочки (%) |
|---|---|
| 0 | 100,0 |
| 10 | 90,4 |
| 25 | 77,8 |
| 50 | 60,5 |
| 75 | 47,1 |
| 100 | 36,6 |
Кривая падает быстро, поскольку при умножении хороший средний показатель не спасает. Каждое дополнительное решение должно оправдывать своё место.
Это не призыв объединить все вызовы API в одну огромную операцию. Часть вызовов детерминирована: получить страницу по известному курсору, сравнить идентификатор или записать поле по одобренному сопоставлению. Модели не нужно заново решать это для каждой записи. Другие вызовы содержат реальную неоднозначность: новое поле поставщика, изменённое сообщение об ошибке или запрос с неясным владельцем. Там может понадобиться суждение.
Практическое разделение: суждение создаёт или исправляет правило, а обычный код применяет устойчивое правило. Reverse ETL показывает повторяющееся перемещение данных: каждую обычную строку должна обрабатывать последовательность кода, не диалог. Агент всё ещё может помочь определить, что ей делать.
Это граница, а не лозунг. Если поставщик меняет значение поля, детерминированное правило способно безупречно повторять ошибку. Системе нужен способ заметить изменение предположений и вернуть случай на проверку.
Почему один большой инструмент не решает проблему
Разумное возражение: «Если длинные цепочки сбиваются, спрячем всю задачу за один вызов инструмента». Это помогает, когда инструмент представляет чёткую операцию с проверяемым результатом. Если же он лишь скрывает длинный неопределённый процесс, не помогает.
Допустим, syncCustomer() возвращает success: true после отправки обновления. Если назначение применяет изменения позже, вызов пока не доказывает окончательное состояние контакта. Инструмент сократил видимые шаги, но не неопределённость.
Лучший интерфейс показывает существенные состояния: принято, применено, проверено или не удалось. За каждым словом должно быть доказательство. Для предварительного просмотра с небольшими последствиями достаточно принятой записи. Изменение аудитории кампании или согласия следует проверить в системе назначения прежде, чем назвать законченным.
В этом предлагаемом виде Tajo принятый запрос и применённое изменение отделены от подтверждённого состояния в целевой системе. Последняя проверка ожидается. У следующего действия есть цель: узнать, что сохранила целевая система. Ещё один успешный вызов инструмента оставил бы исходный вопрос без ответа.
Завершённая запись всё ещё требует доказательств
Завершилась ли синхронизация клиентов?
Запись применена. Проверка ожидается.
Состояние в целевой системе ещё не проверено.
Активность синхронизации
- Запрос принят
- Изменение применено
- Проверка целевой системы ожидается
Пример выполнения · 14:32 UTC
Что известно
- Ответ провайдера
- Принято
- Результат записи
- Применено
- Повторное чтение из целевой системы
- Ожидается
Успешный вызов не доказывает конечное состояние.
Предлагаемый вид основан на ленте активности Tajo. Иллюстрация добавляет состояние проверки; она не утверждает, что повторное чтение из целевой системы уже реализовано.
Меняется и измерение. Сохраняйте число попыток, если это помогает оценить затраты. Записывайте промежуточные ошибки, если они указывают на неисправный шаг. Но оценивайте процесс по проверенным завершённым операциям и указывайте метод проверки рядом с числом. Сообщение «99% вызовов прошли успешно» ещё не отвечает, удалось ли клиентам выполнить задачу.
Объяснение MCP-сервера показывает, как инструменты дают помощнику доступ к другой системе. Доступ к инструменту лишь начало. Обязательство определяется оставленным состоянием.
Сто хороших кликов могут не дать ничего. Считайте результат.
Часто Задаваемые Вопросы
Почему длинный процесс не срабатывает, если отдельные шаги обычно верны?
Если каждый шаг успешно выполняется независимо с вероятностью p, вероятность успеха цепочки из n шагов равна p в степени n. При условных 99% на шаг сто шагов завершаются примерно в 36,6% случаев. Реальные ошибки могут зависеть друг от друга, поэтому расчёт служит примером, а не измеренной характеристикой агента.
Гарантирует ли сокращение вызовов инструментов надёжность?
Нет. Меньше вызовов помогает, только если объединённая операция сохраняет нужные проверки и точки восстановления. Один непрозрачный вызов может скрыть неудачную запись так же, как длинная цепочка может потерять контекст.
Что измерять команде для процесса с агентом?
Проверенное завершение задачи пользователя, а не только успешные вызовы модели. Определите объект или состояние системы назначения, доказывающее выполнение задачи, и считайте, как часто оно появляется после всего процесса.